通过测试能说明什么?
SWE-Bench 使用真实软件问题中的测试来评估补丁。这些测试可能遗漏相关情况,使错误的修复也被判定为通过。
检验评估本身
UTBoost 基于 UTGenerator 构建,后者通过分析 Python 项目及其依赖生成额外测试。UTBoost 对比生成补丁与参考补丁的行为,并改进了读取测试结果的解析器。
论文报告的结果
ACL 2025 论文报告的评估在 SWE-Bench Lite 与 Verified 中识别出 345 个此前被判定为通过的错误补丁。
代表性研究
增强用于评估编程智能体的测试,让通过基准测试更能反映修复是否正确。
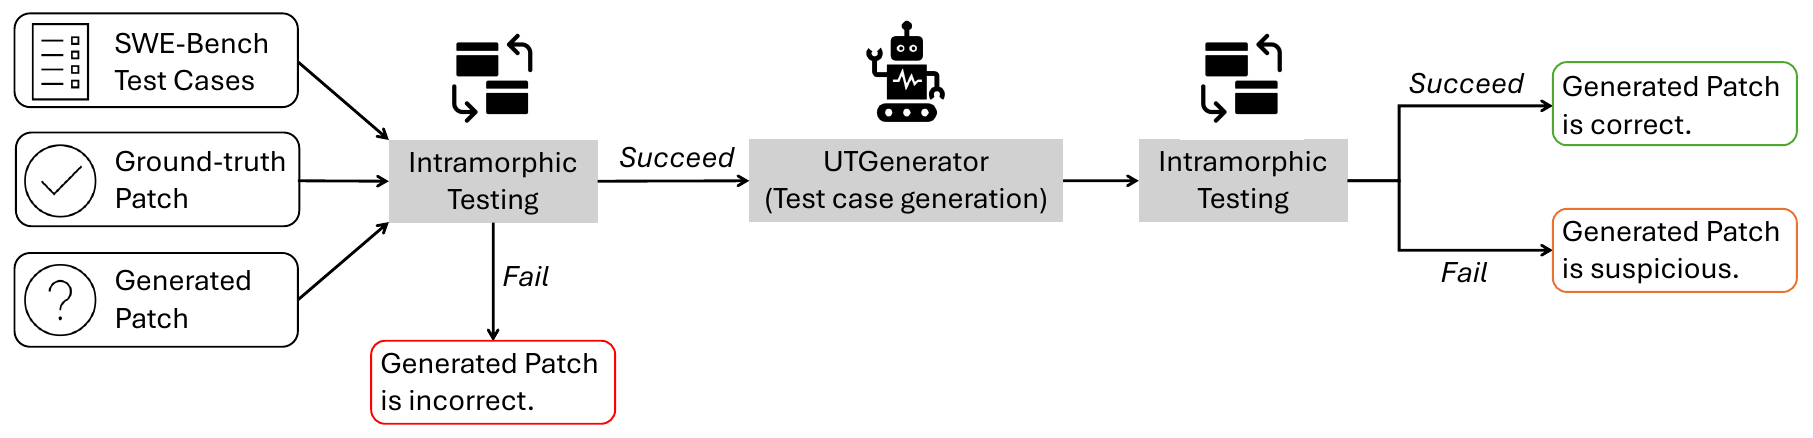
SWE-Bench 使用真实软件问题中的测试来评估补丁。这些测试可能遗漏相关情况,使错误的修复也被判定为通过。
UTBoost 基于 UTGenerator 构建,后者通过分析 Python 项目及其依赖生成额外测试。UTBoost 对比生成补丁与参考补丁的行为,并改进了读取测试结果的解析器。
ACL 2025 论文报告的评估在 SWE-Bench Lite 与 Verified 中识别出 345 个此前被判定为通过的错误补丁。
· + 同等贡献
本页介绍依据所链接的公开来源。